招聘与薪酬工作台:从原稿到 AI 招聘助手,一套系统怎样真正做到可用
这次项目最难的并不是把页面做出来,而是克制。客户已经给了完整原型,也明确说了喜欢什么。开发者真正要做的,不是拿一套通用后台模板覆盖原稿,而是先读懂侧栏宽度、KPI 顺序、卡片布局、颜色关系和业务语义,再在不动骨架的前提下把系统做活。
最终交付的招聘与薪酬工作台覆盖岗位、候选人、编制、面试、Offer、数据报表、AI 招聘辅助和系统内使用手册。本文复盘这次从原稿恢复到完整系统的过程。
一、原稿是最高约束,不是参考图
第一版开发时,我犯过一个典型错误:看到 Y2Ksoft 有通用暗色玻璃规范,就直接把客户的浅紫原型替换掉了。功能虽然更多,但客户第一眼就说“你没有按我的风格来”。这句话是对的。
后来重新处理时,先把原稿里的关键视觉变量逐项提取:
| 项目 | 原稿约束 | 恢复结果 |
|---|---|---|
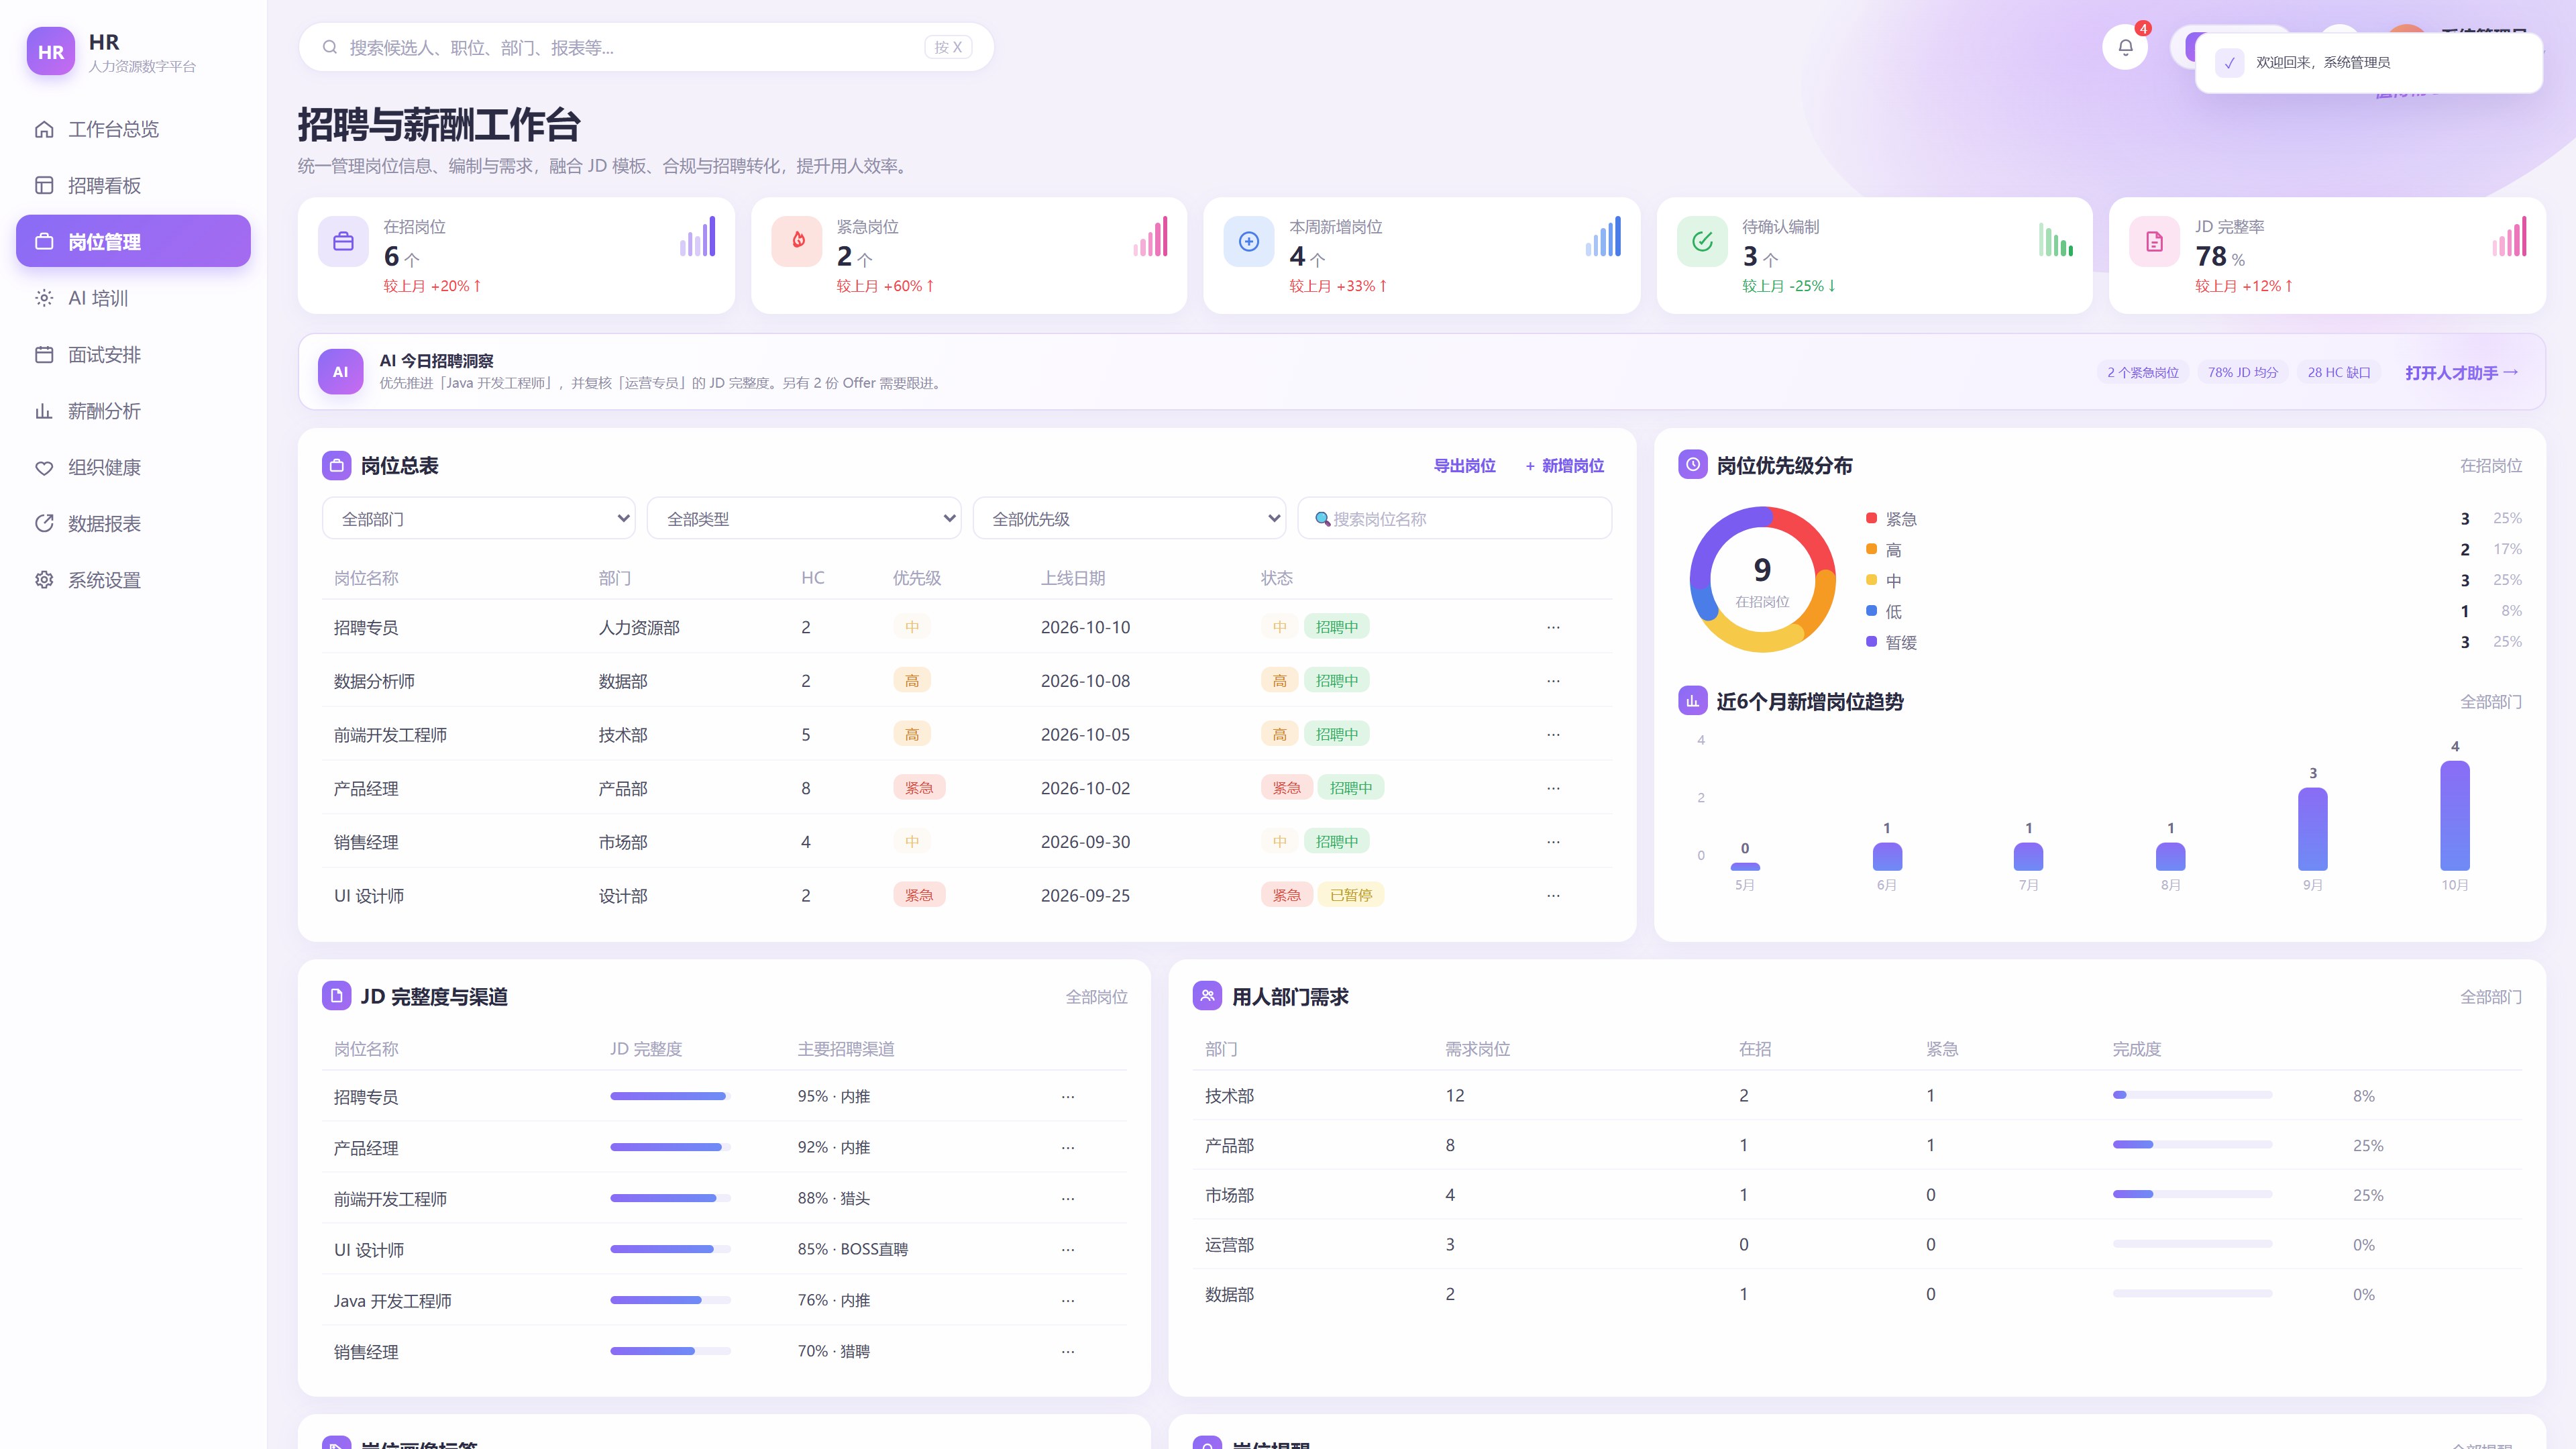
| 侧栏 | 200px、浅紫白底、9 项原始导航 | 保持一致 |
| 主背景 | #f4f1fb + 多层紫色光晕 | 保持一致 |
| 首页 KPI | 5 列:在招、紧急、新增、编制、JD | 保持一致 |
| 页面骨架 | 岗位总表、环图、趋势、JD、部门需求、标签、提醒 | 保持一致 |
| 登录页 | 客户明确要求保留并优化协调性 | 改为同色系浅紫玻璃 |
二、登录页与主系统怎样协调
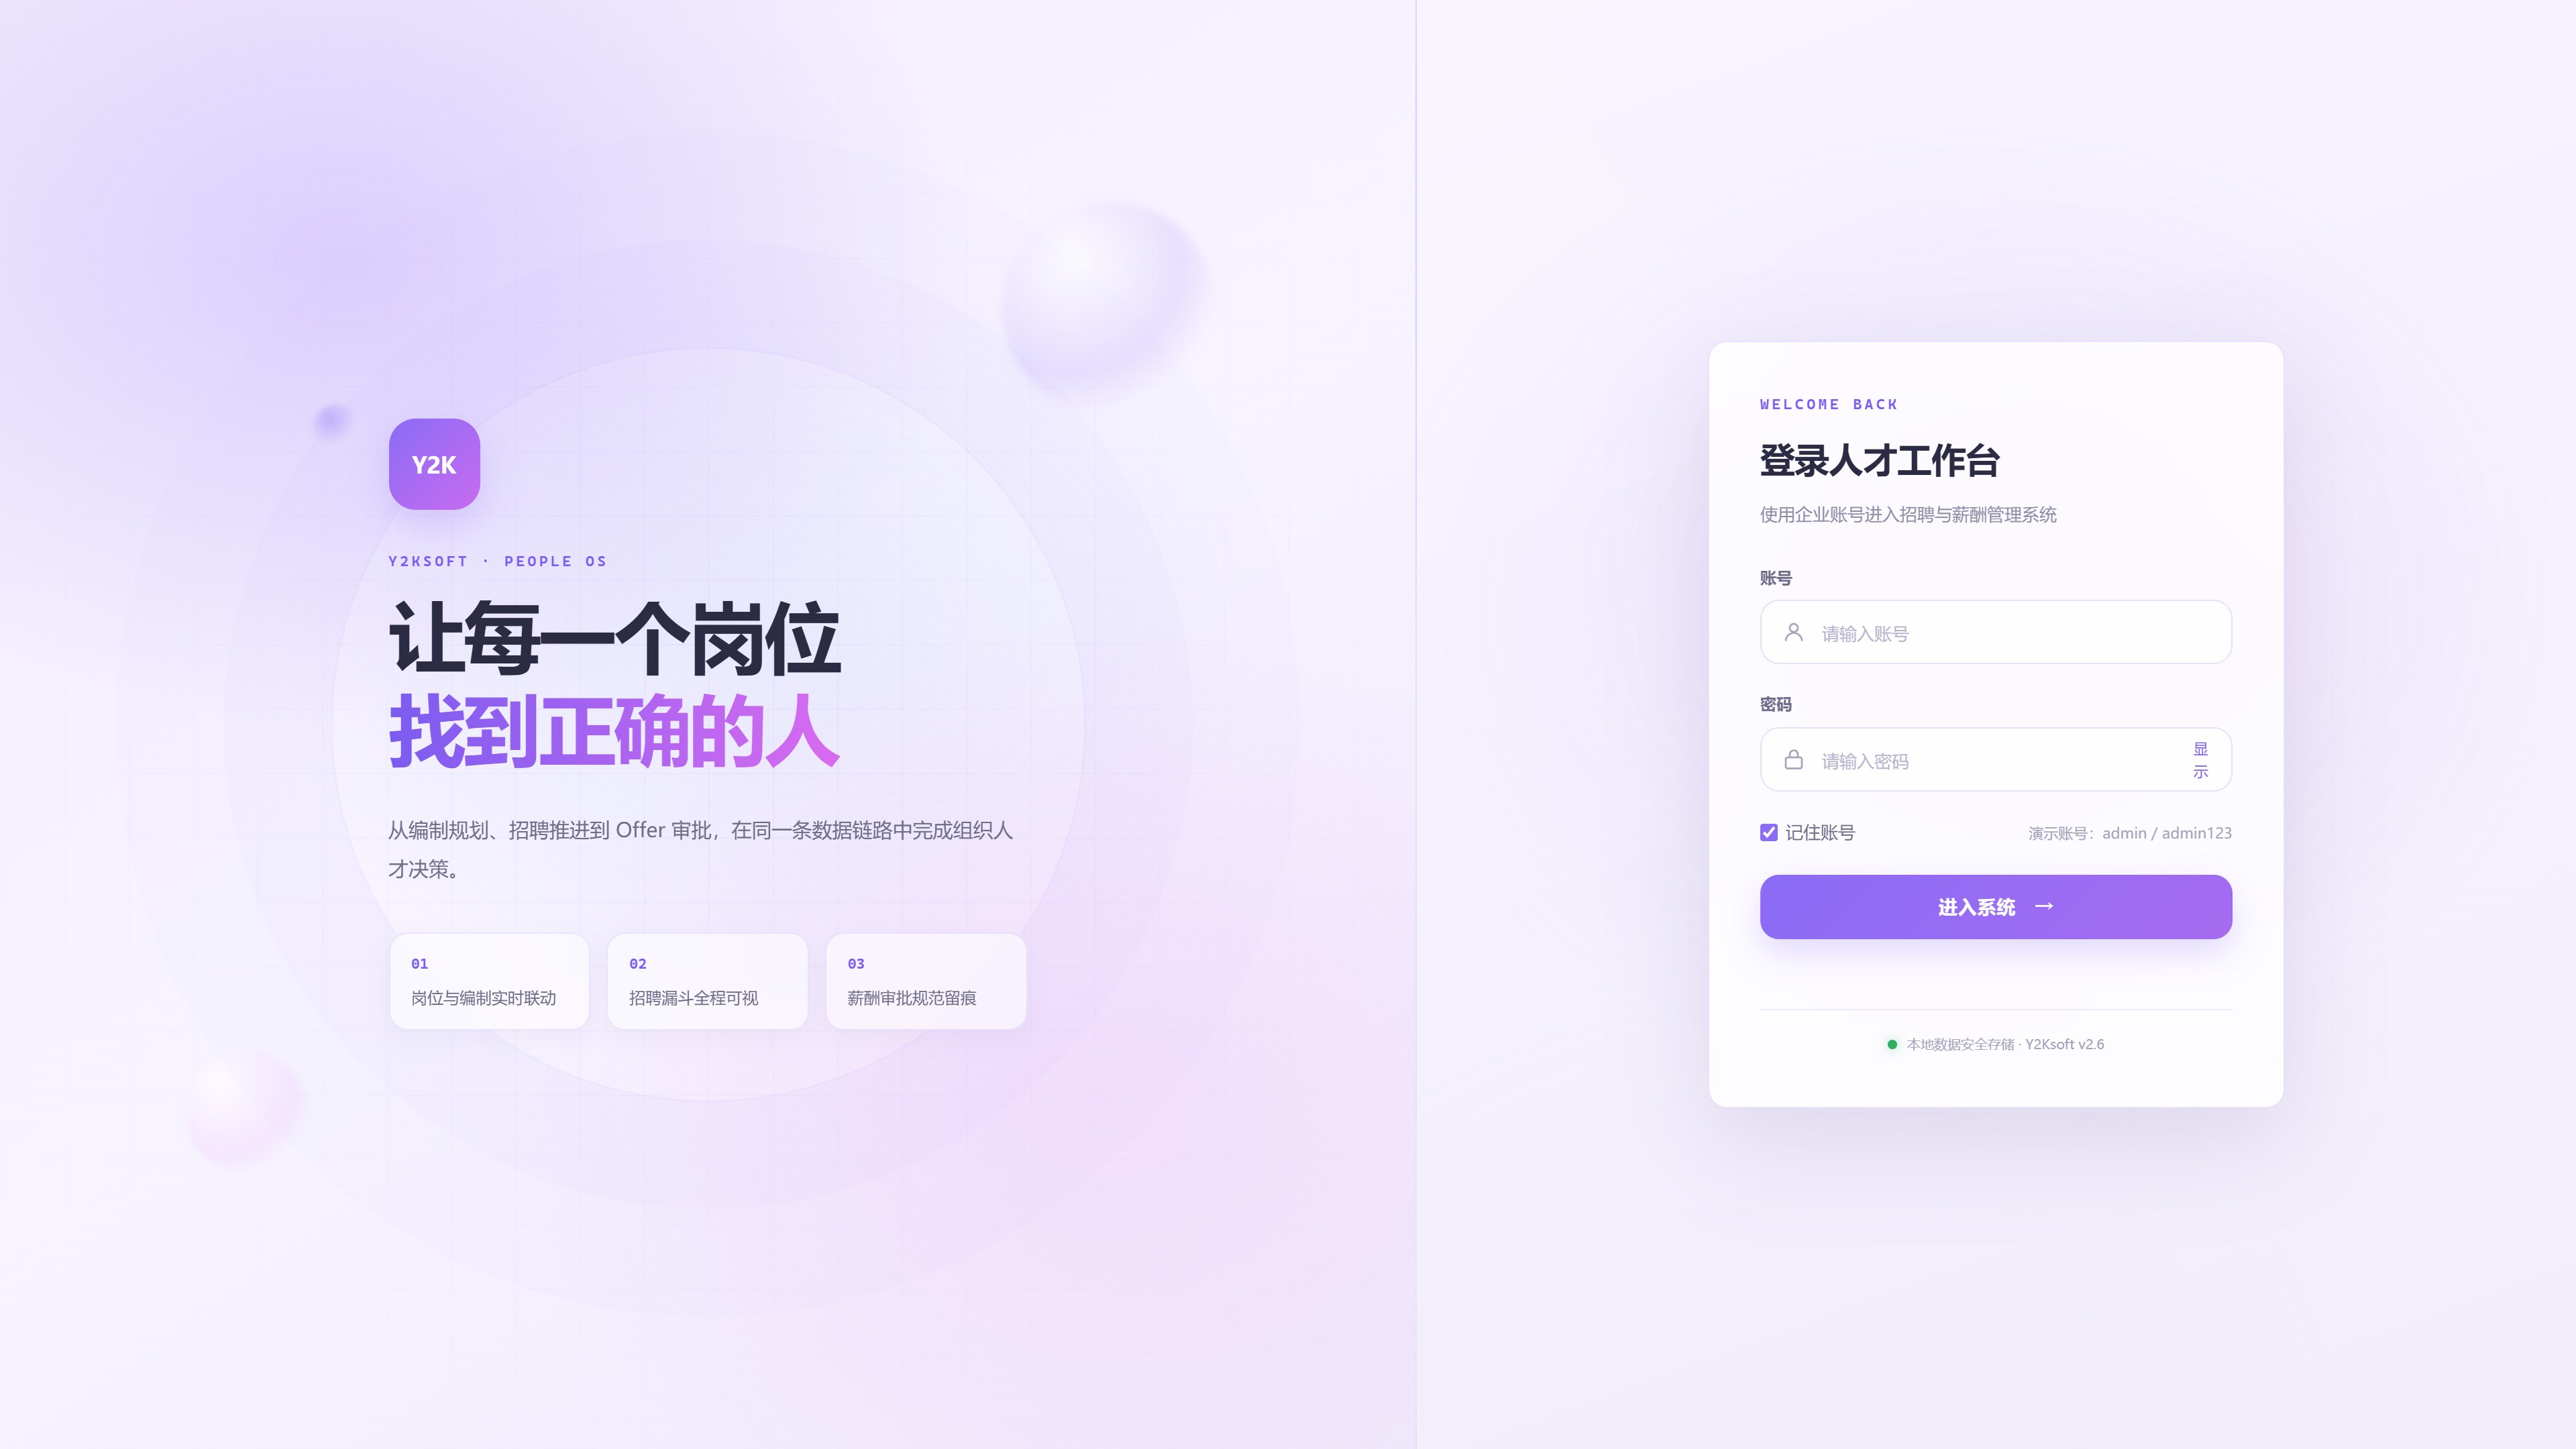
原稿主系统是浅紫、白卡片、低饱和阴影。早期登录页是深色科技风,单独看不错,放进系统却像两个产品。这次登录页没有换成另一套模板,而是直接继承主系统的视觉变量:同样的 #f4f1fb、紫色光晕、白色玻璃卡片、14px 圆角和紫色主按钮。
- 背景统一:主系统和登录页共用浅紫渐变与多层径向光。
- 主色统一:按钮、Logo、重点文字使用 #8a6cf5 → #c86bf0。
- 层次统一:白卡片 + 轻阴影 + 低饱和边框,不堆叠高对比颜色。
- 登录交互保留:账号密码、Enter 登录、密码显示切换、错误提示。
三、招聘链路不是页面集合,而是一条状态链
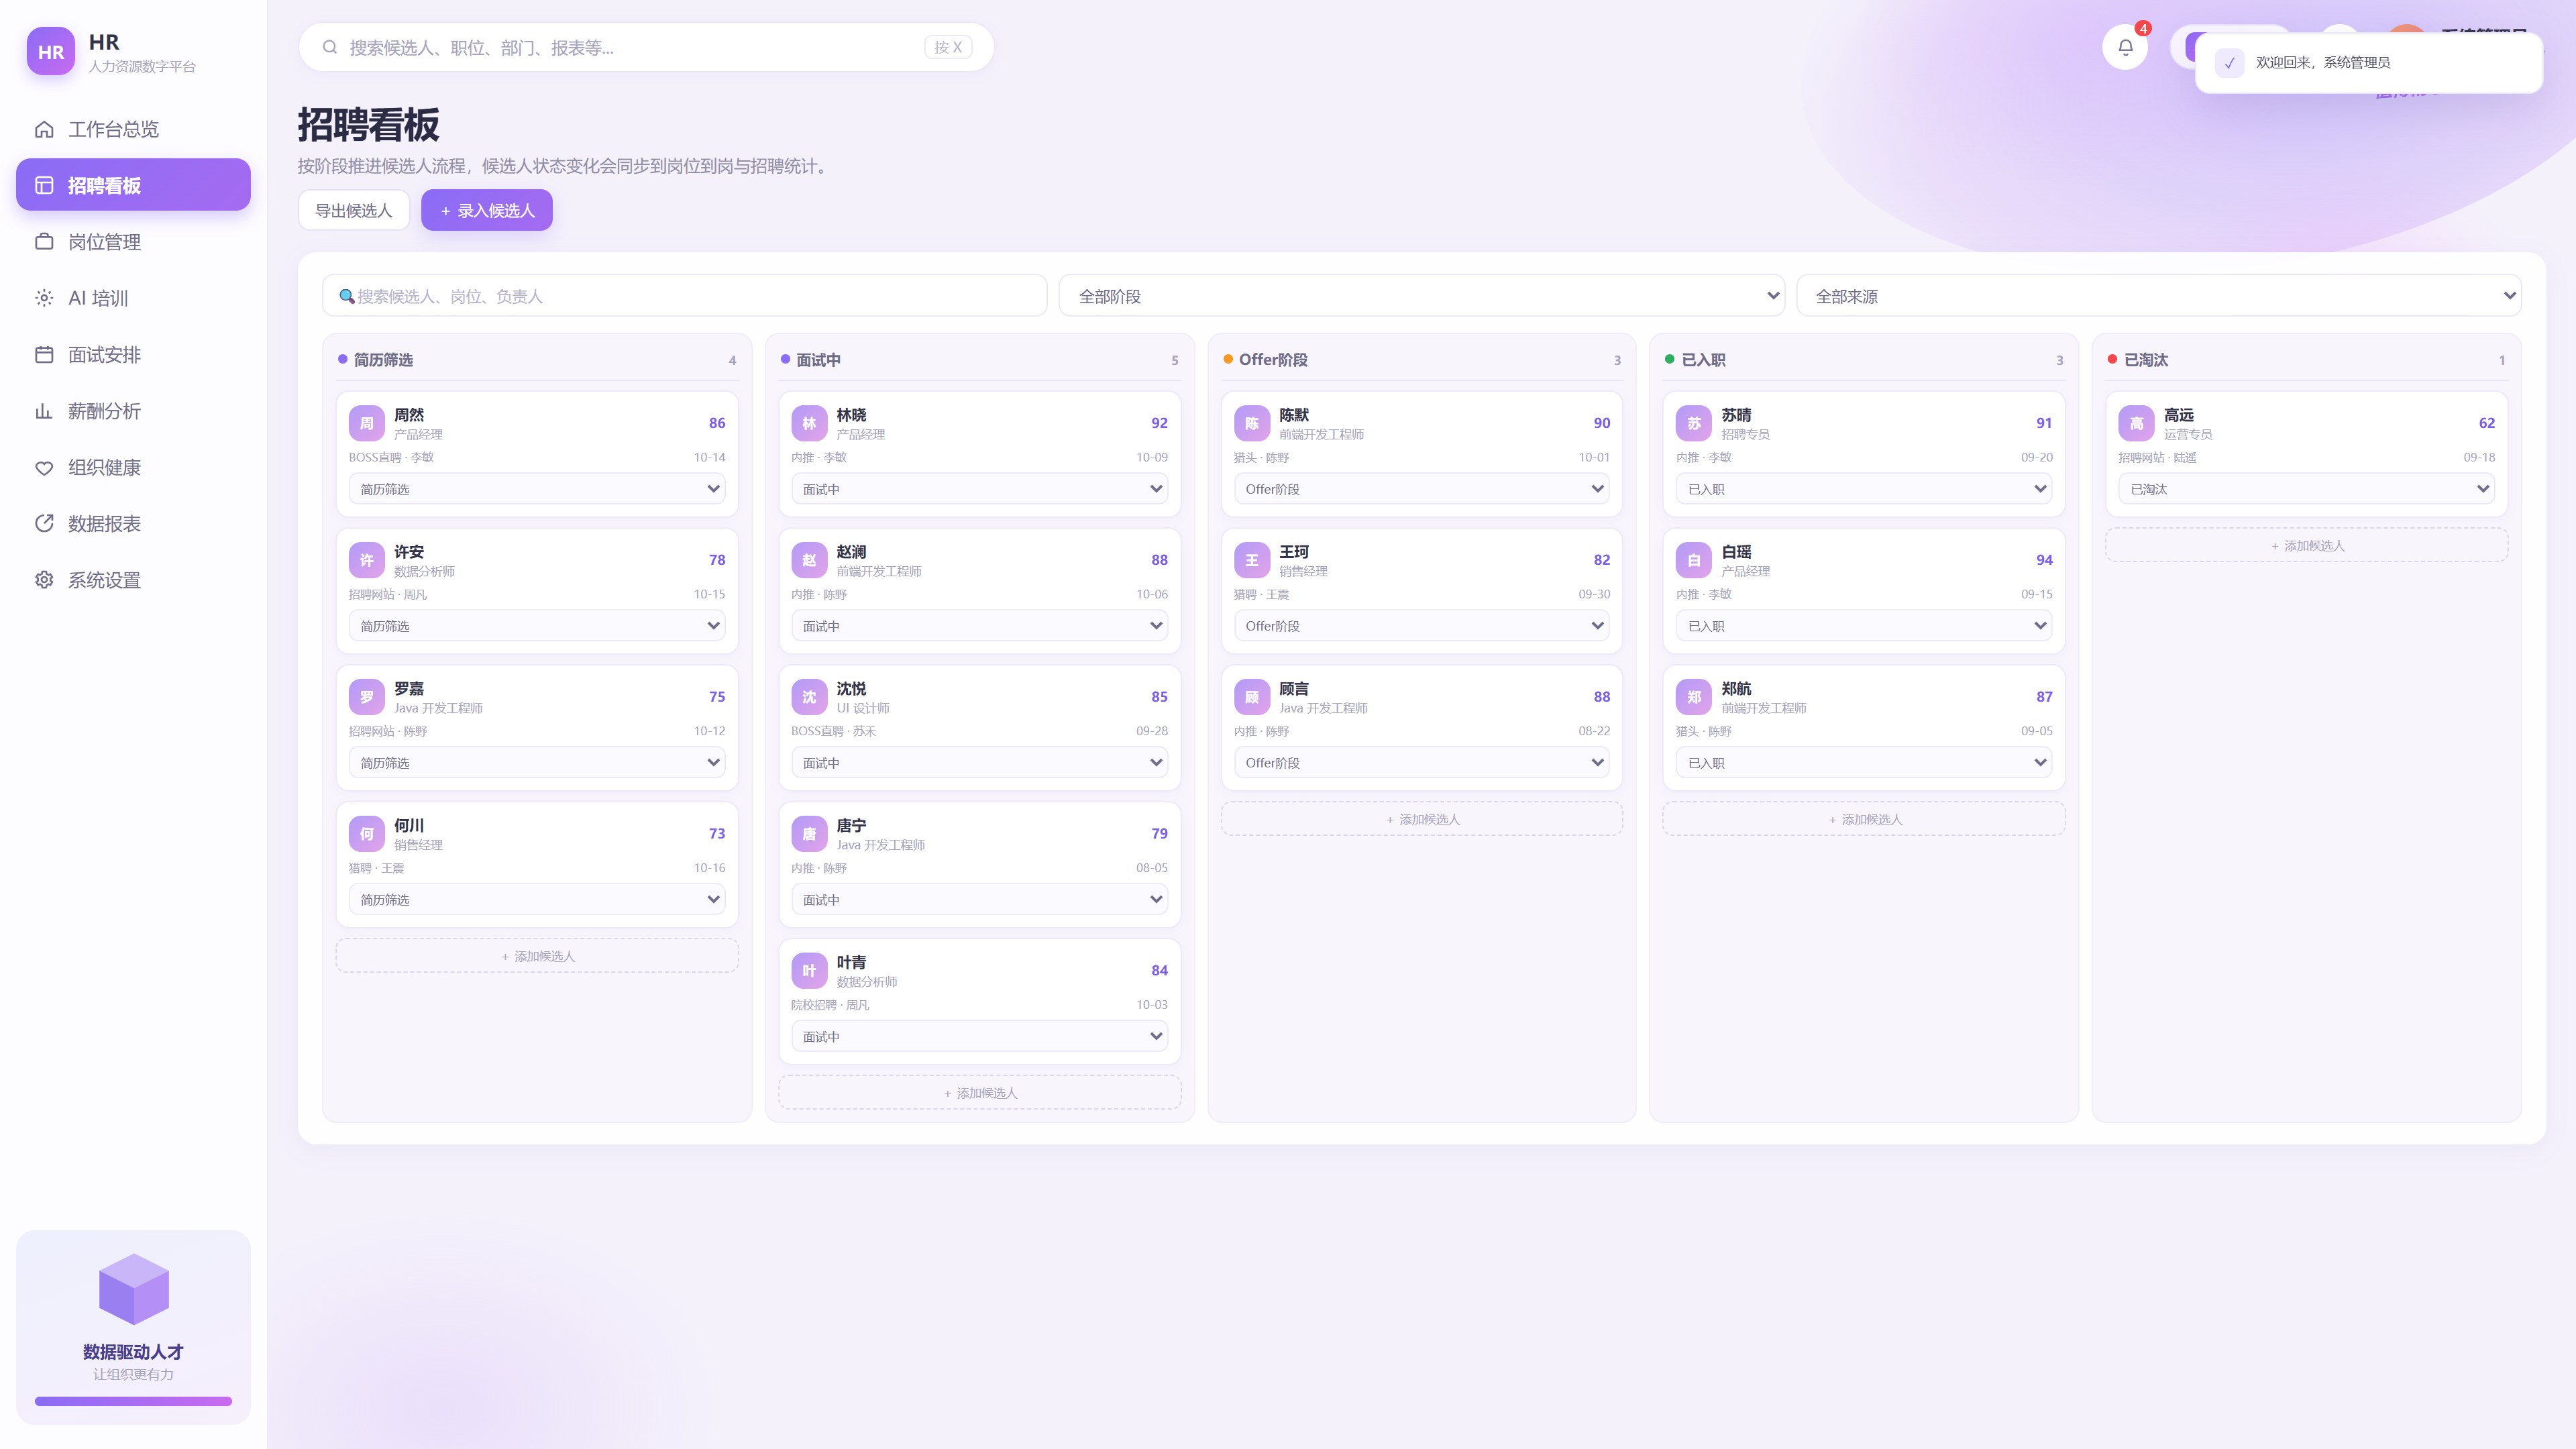
系统里的岗位、候选人和 Offer 不是孤立数据。候选人从“面试中”进入“已入职”,对应岗位的到岗人数要同步增加;候选人接受 Offer 后也要自动进入已入职,但不能重复累加。这些看起来是小逻辑,实际决定了数据是否可信。
四、AI 应该介入哪里,而不是到处加聊天框
招聘系统并不需要每个页面都塞一个聊天输入框。AI 真正有价值的位置,是那些每天需要判断、但又缺少结构化辅助的环节。
| 业务环节 | AI 介入方式 | 系统输出 |
|---|---|---|
| JD 编写 | 检查完整度、标签、描述、薪酬带宽 | 结构化补充建议,一键应用 |
| 候选人筛选 | 结合评分、来源、标签、阶段和备注 | 优先沟通候选人与匹配分 |
| 面试准备 | 读取岗位画像和候选人信息 | 6 道针对性面试题 |
| Offer 沟通 | 比较薪资带宽、评分、奖金结构 | 接受风险等级与跟进建议 |
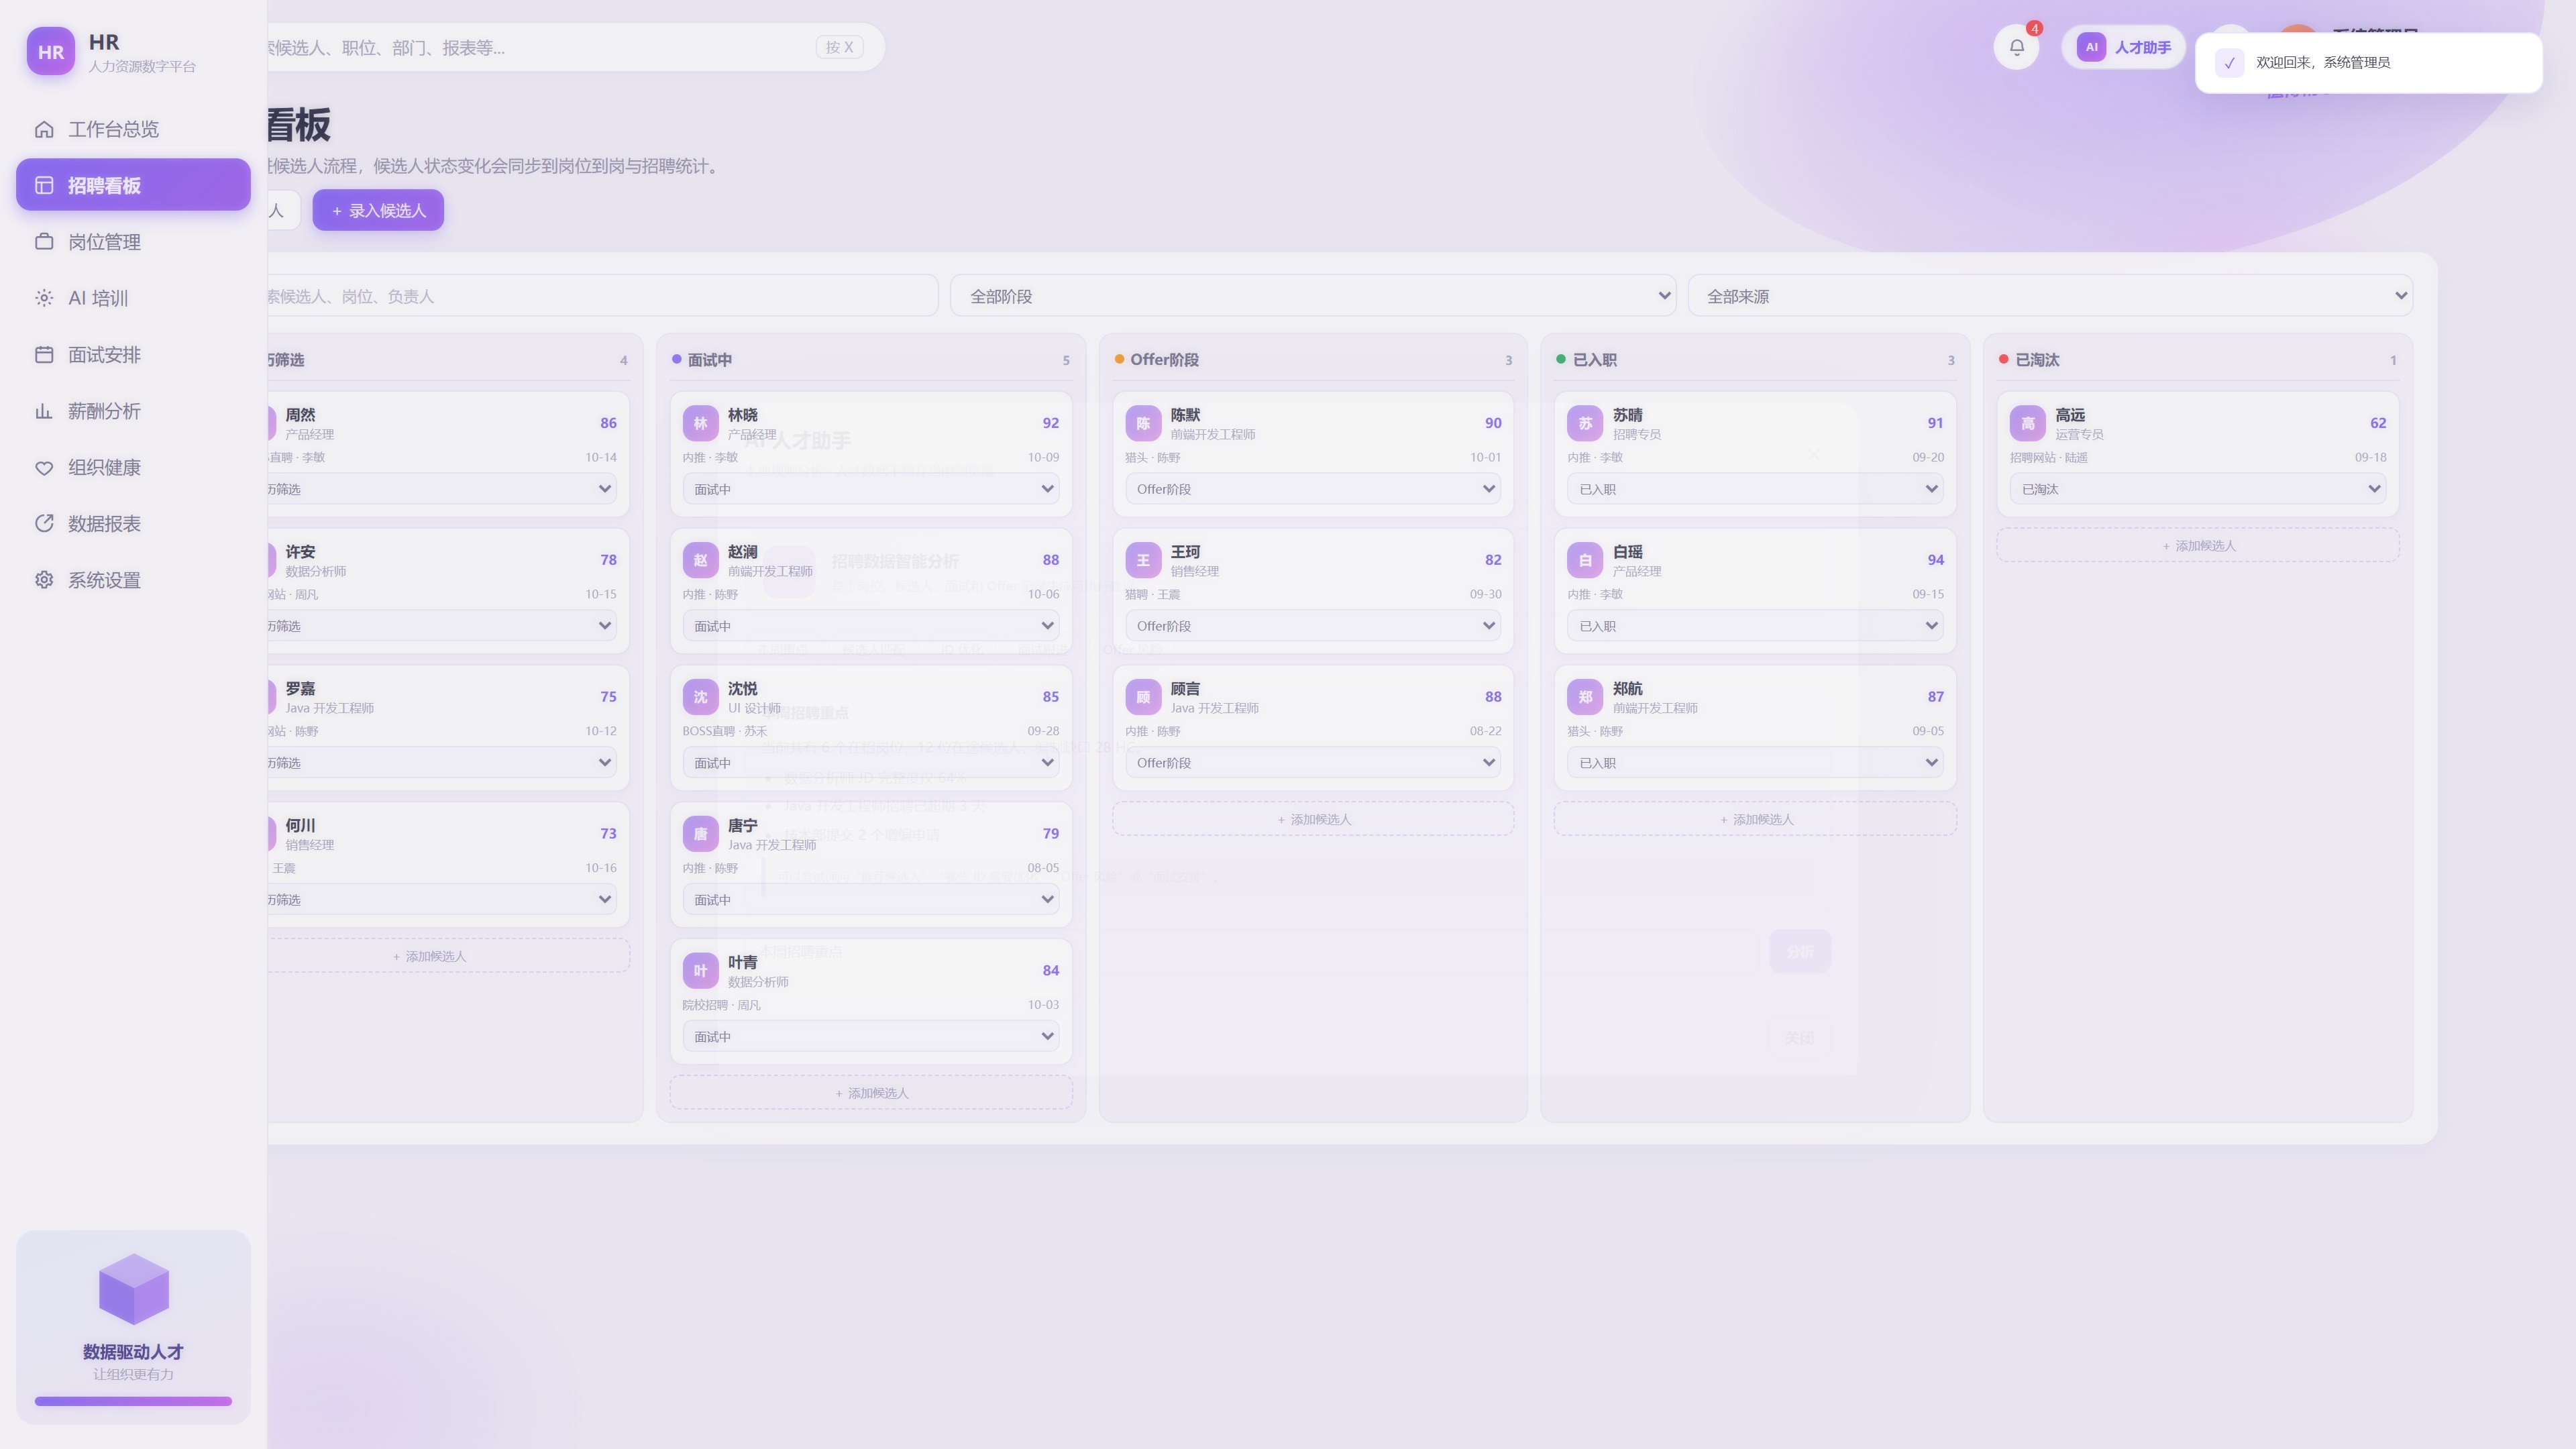
| 招聘复盘 | 聚合 KPI、超期、低 JD、编制缺口 | 本周重点和可执行动作 |
当前 AI 采用本地规则分析。这不是为了炫技,而是因为候选人姓名、电话、薪资和 Offer 都属于敏感数据。对于私有化交付的第一版,本地分析可以先把结构化判断跑通,不把人才数据发送到外部服务。未来接企业私有模型时,再替换推理层即可。
五、金额、备份和可追溯性
薪酬系统里最不能接受的是“看起来差不多”。金额如果直接使用浮点数,多次计算后就可能出现精度问题。本项目把所有金额统一转成整数“分”存储,展示和导出时再格式化:
除了金额,系统还保留了导出、备份、打印和操作记录。岗位、候选人、Offer、编制和分析简报都可以导出 CSV;完整业务数据可以导出 JSON。客户在换电脑或清理浏览器之前,不需要找人帮忙,自己就能完成备份。
六、使用手册必须放进系统里
交付系统时,手册不能只放在硬盘某个 docs 目录里,更不能假设客户会自己去翻。最终版本把使用手册做成了系统页面:点击顶部问号或系统设置里的“系统内手册”,就能直接看到快速开始、角色分工、岗位、招聘看板、AI、编制、Offer、数据安全和 FAQ,同时保留 PDF 下载。
这解决了一个很实际的问题:客户培训时不需要再打开另一个文档,截图、流程和系统入口都在同一个地方。
七、系统截图
01 · 登录页:与主系统统一浅紫体系
02 · 岗位工作台:严格保留客户原稿骨架
03 · 招聘看板:候选人按阶段推进
04 · AI 人才助手:本地数据生成结构化建议
05 · 薪酬分析:Offer 审批与年度总包
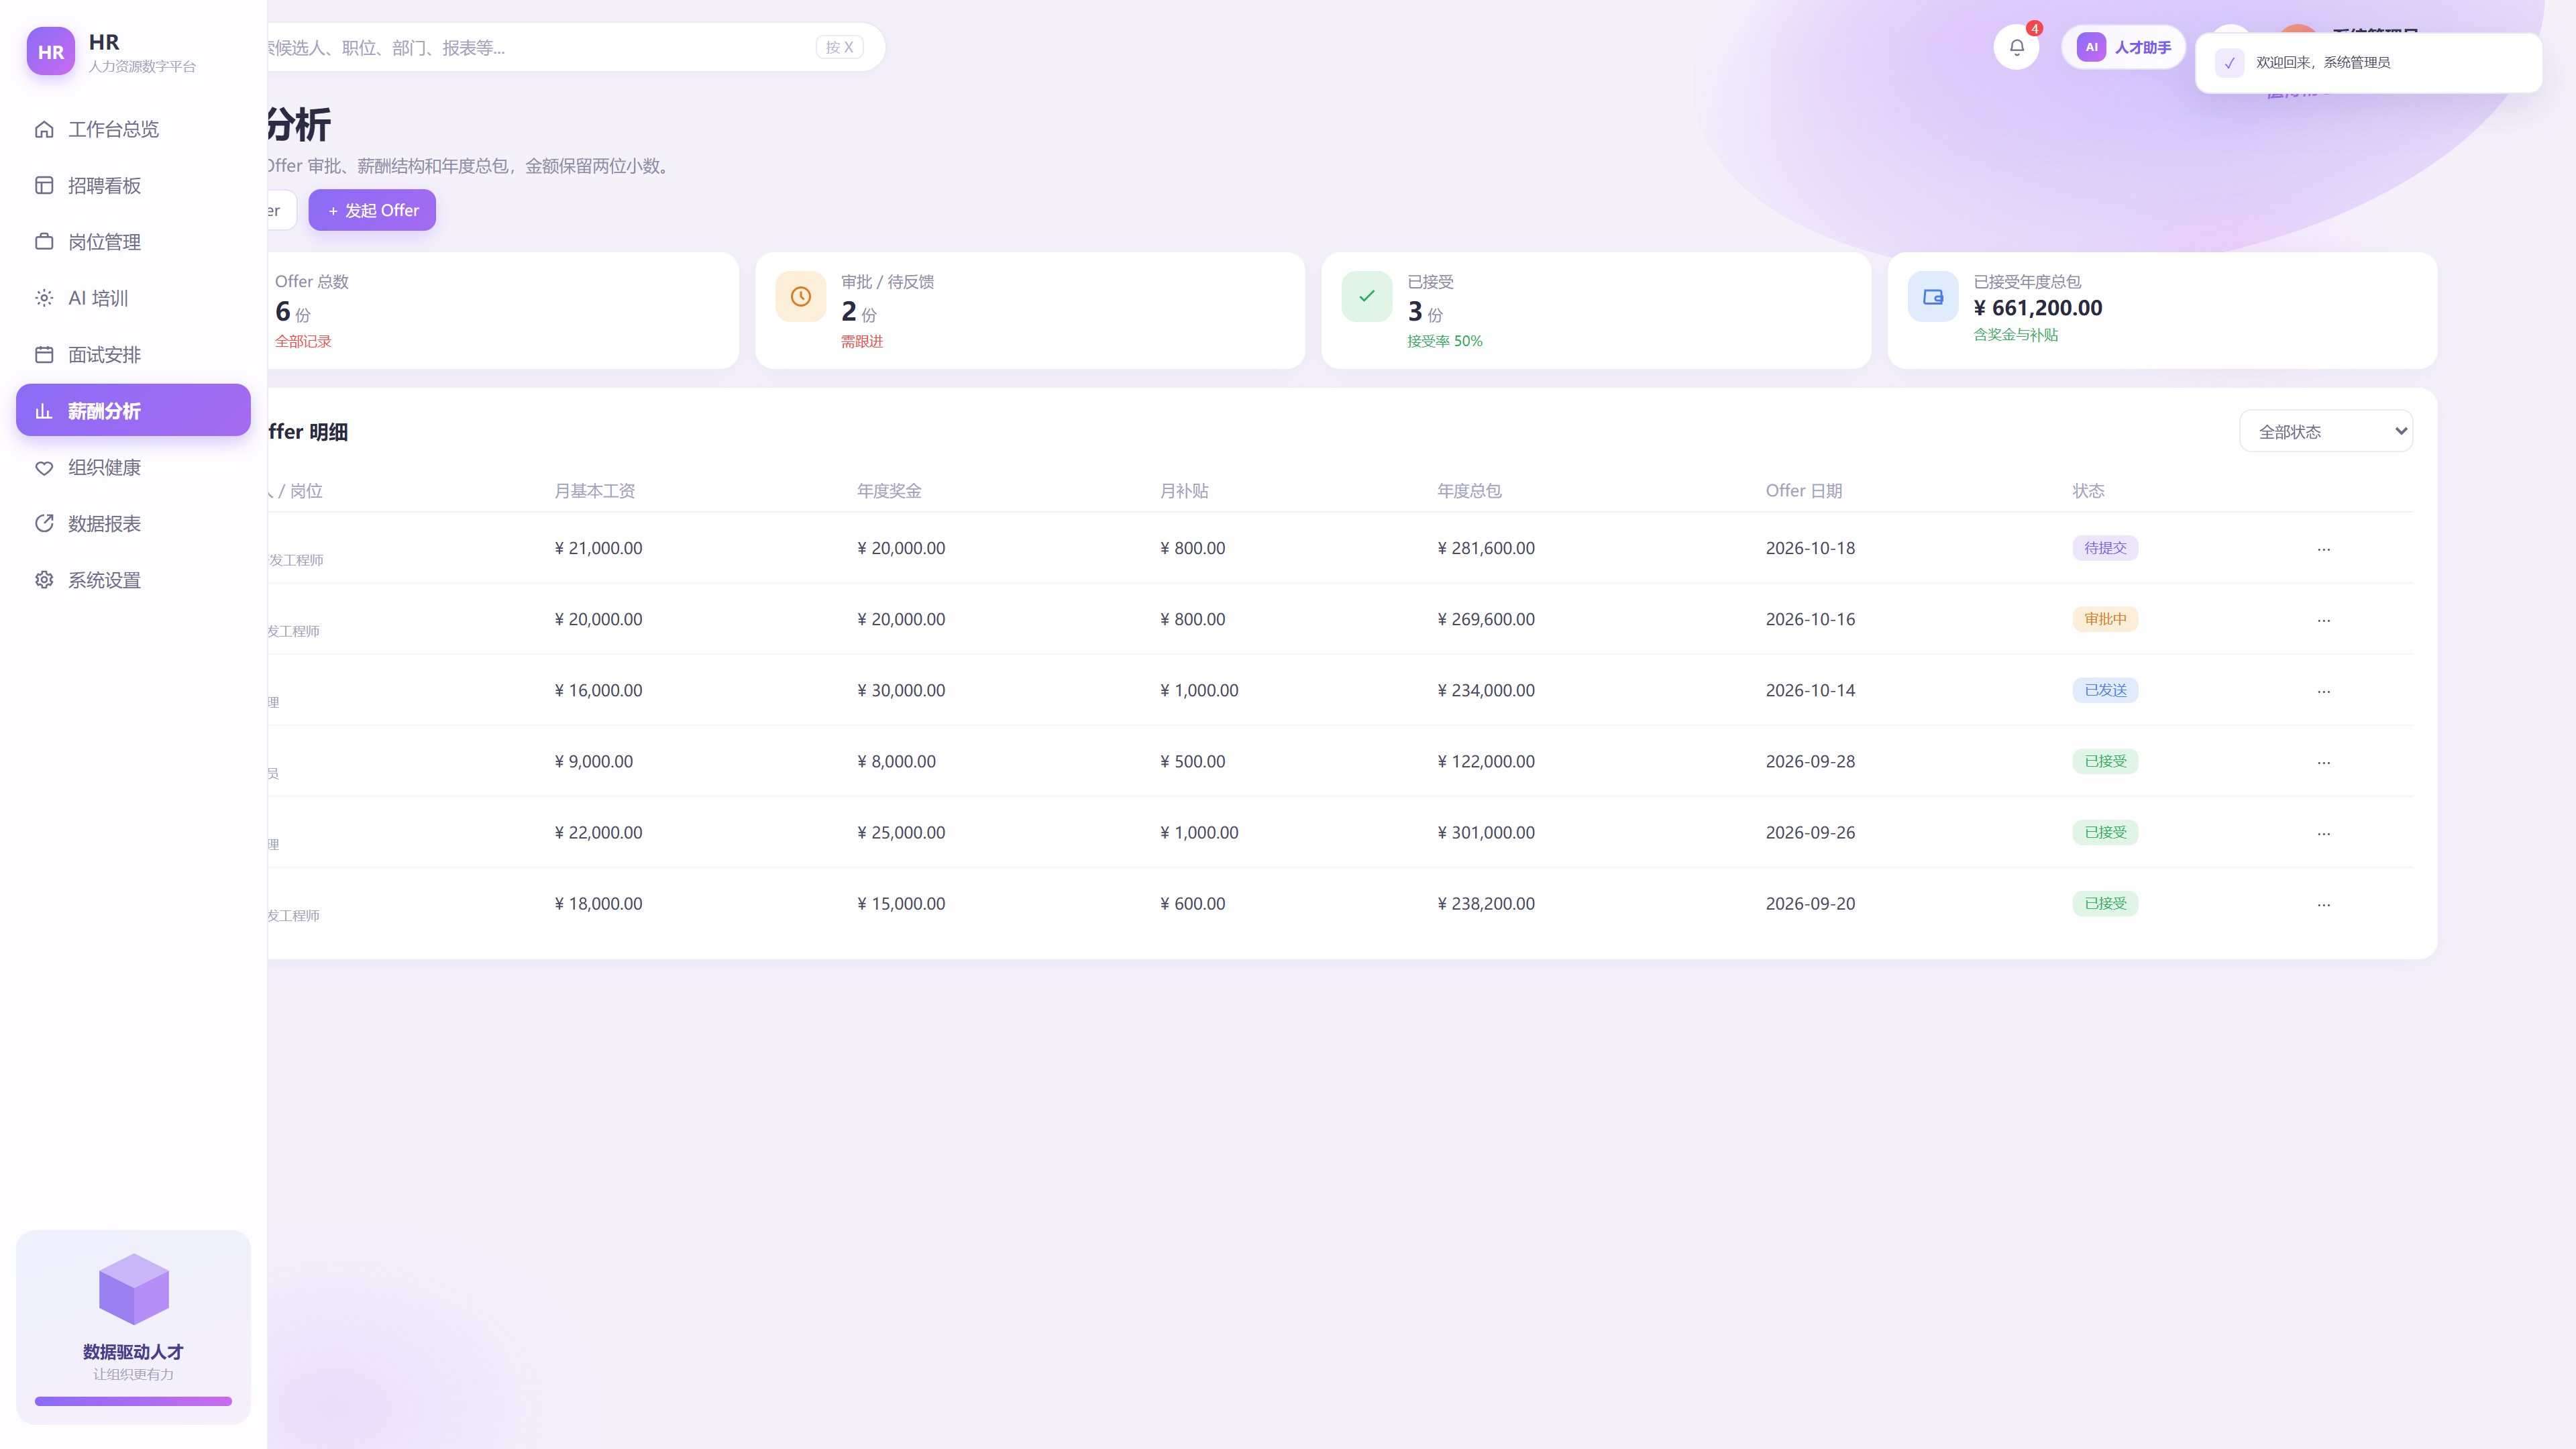
06 · 组织健康:编制、到岗、缺口和增编审批
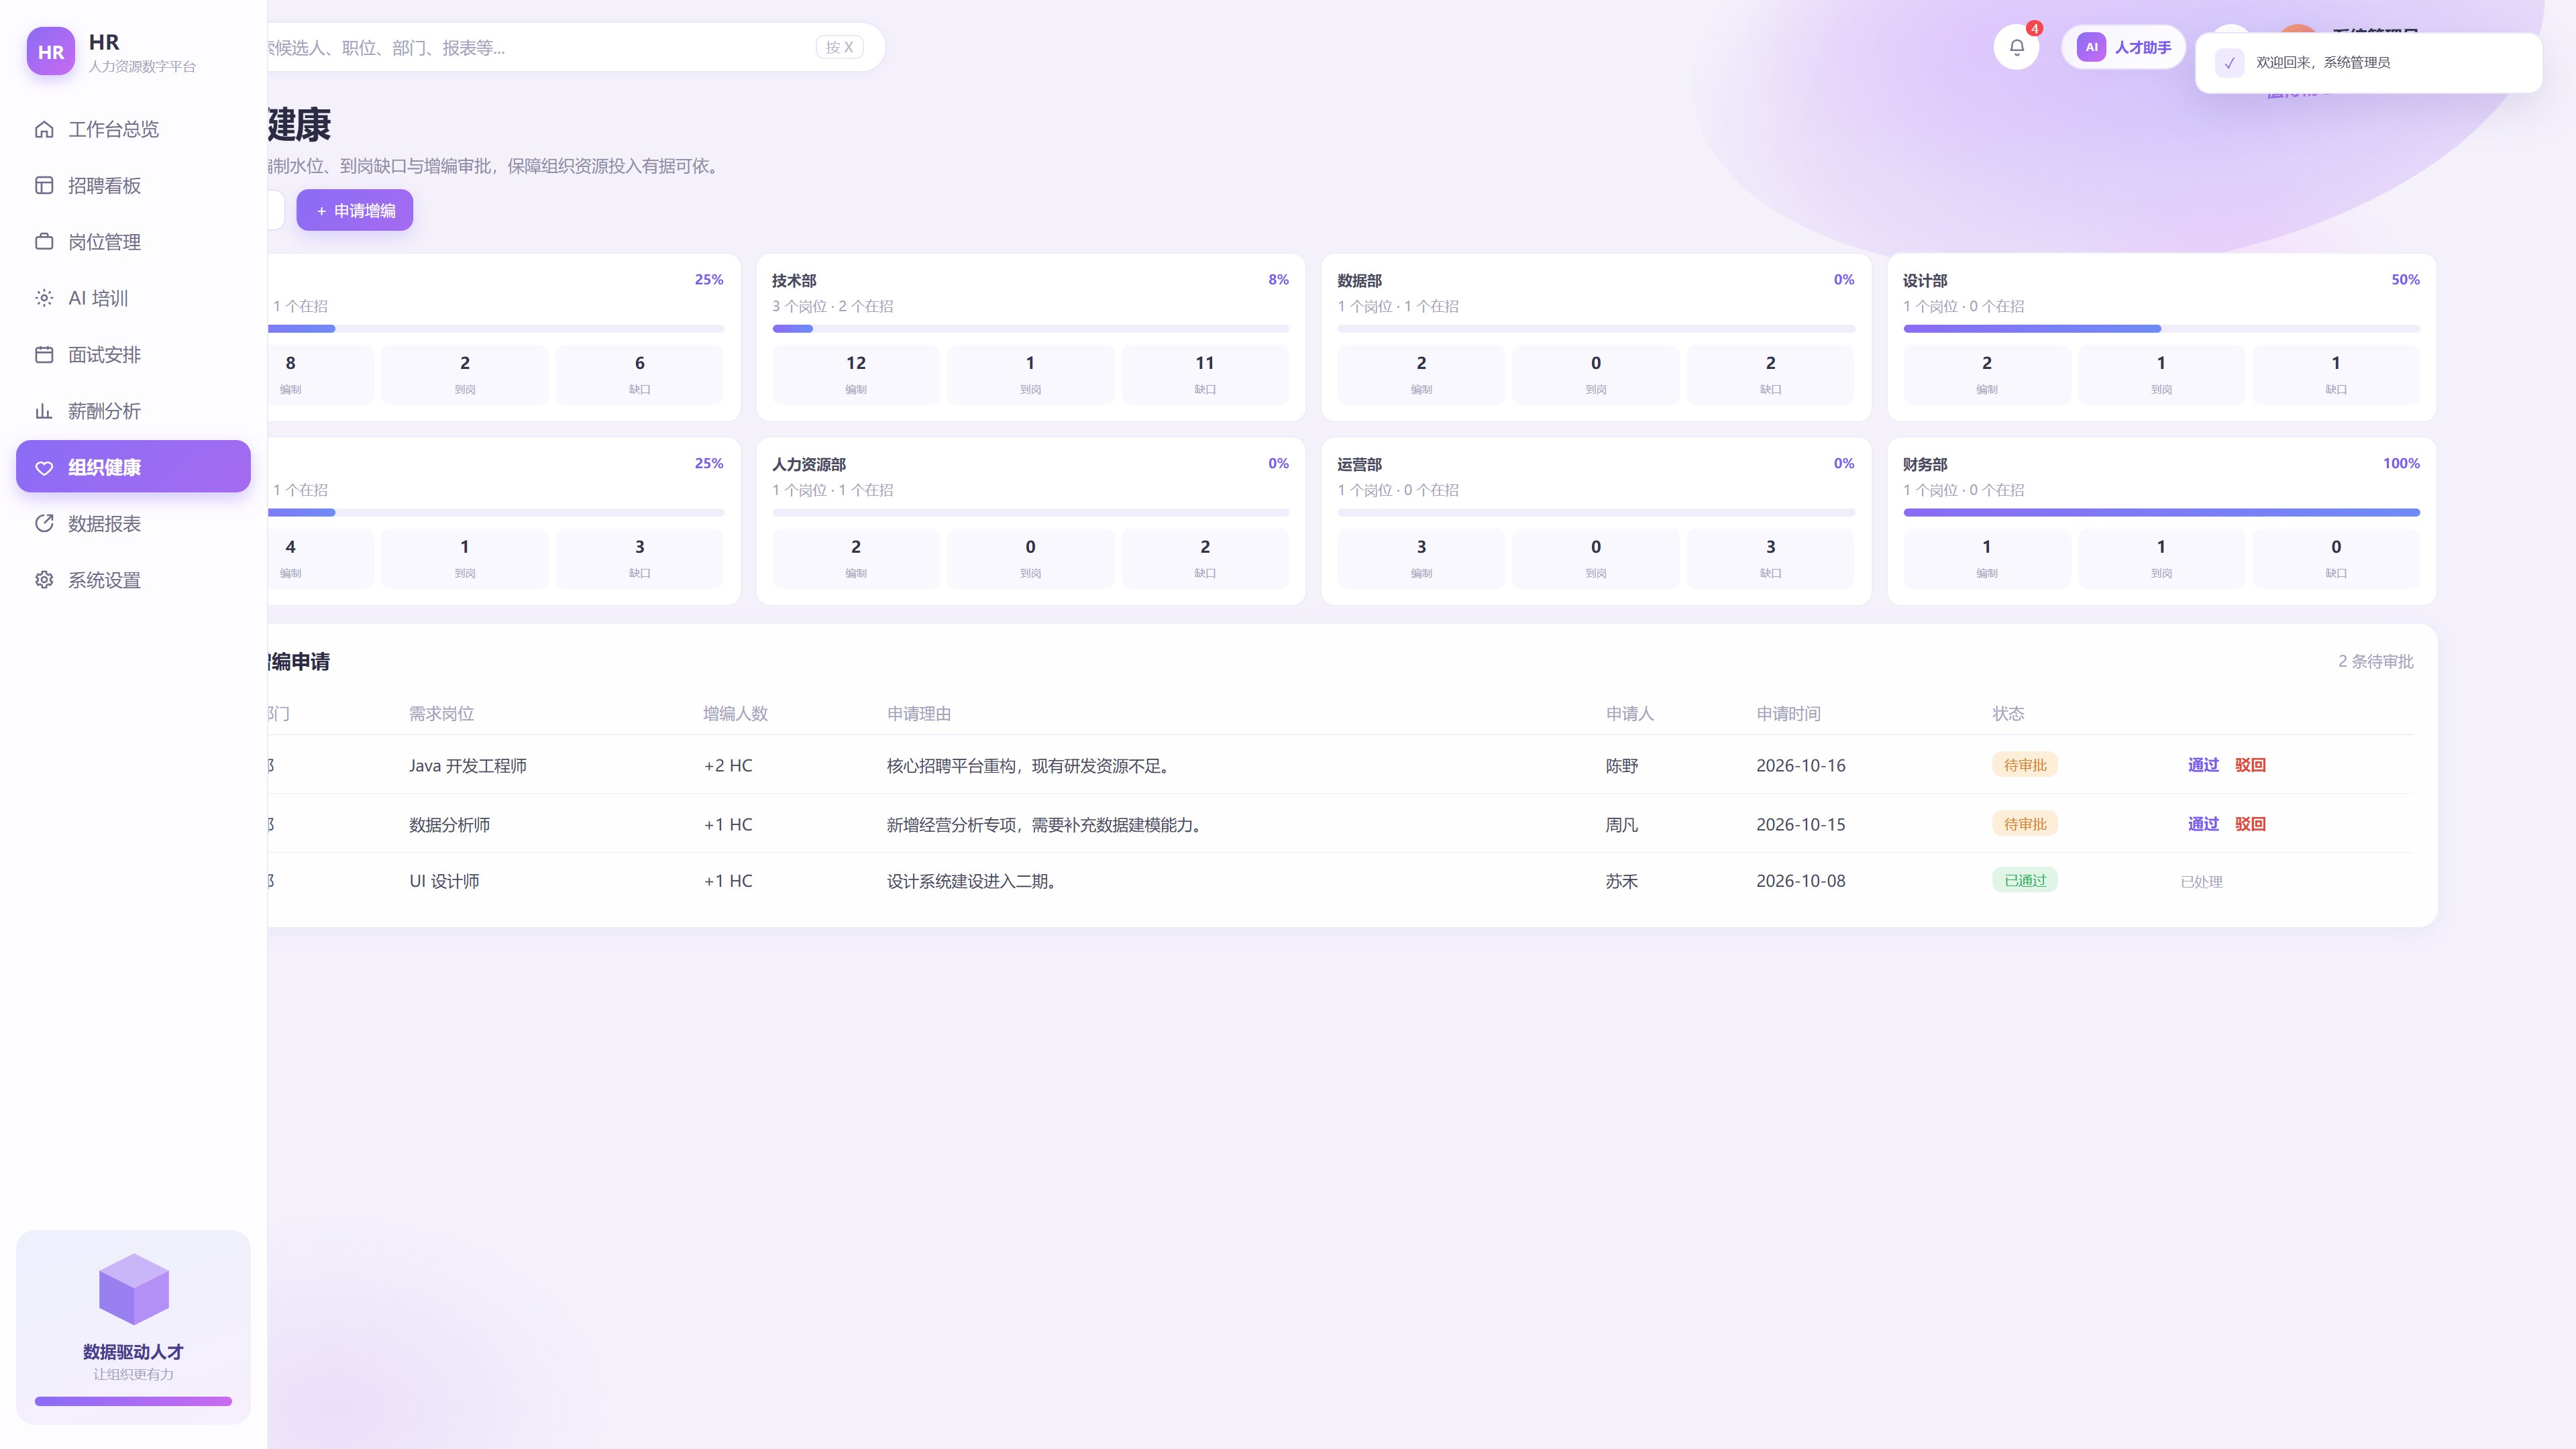
07 · 系统内使用手册:客户不用翻硬盘
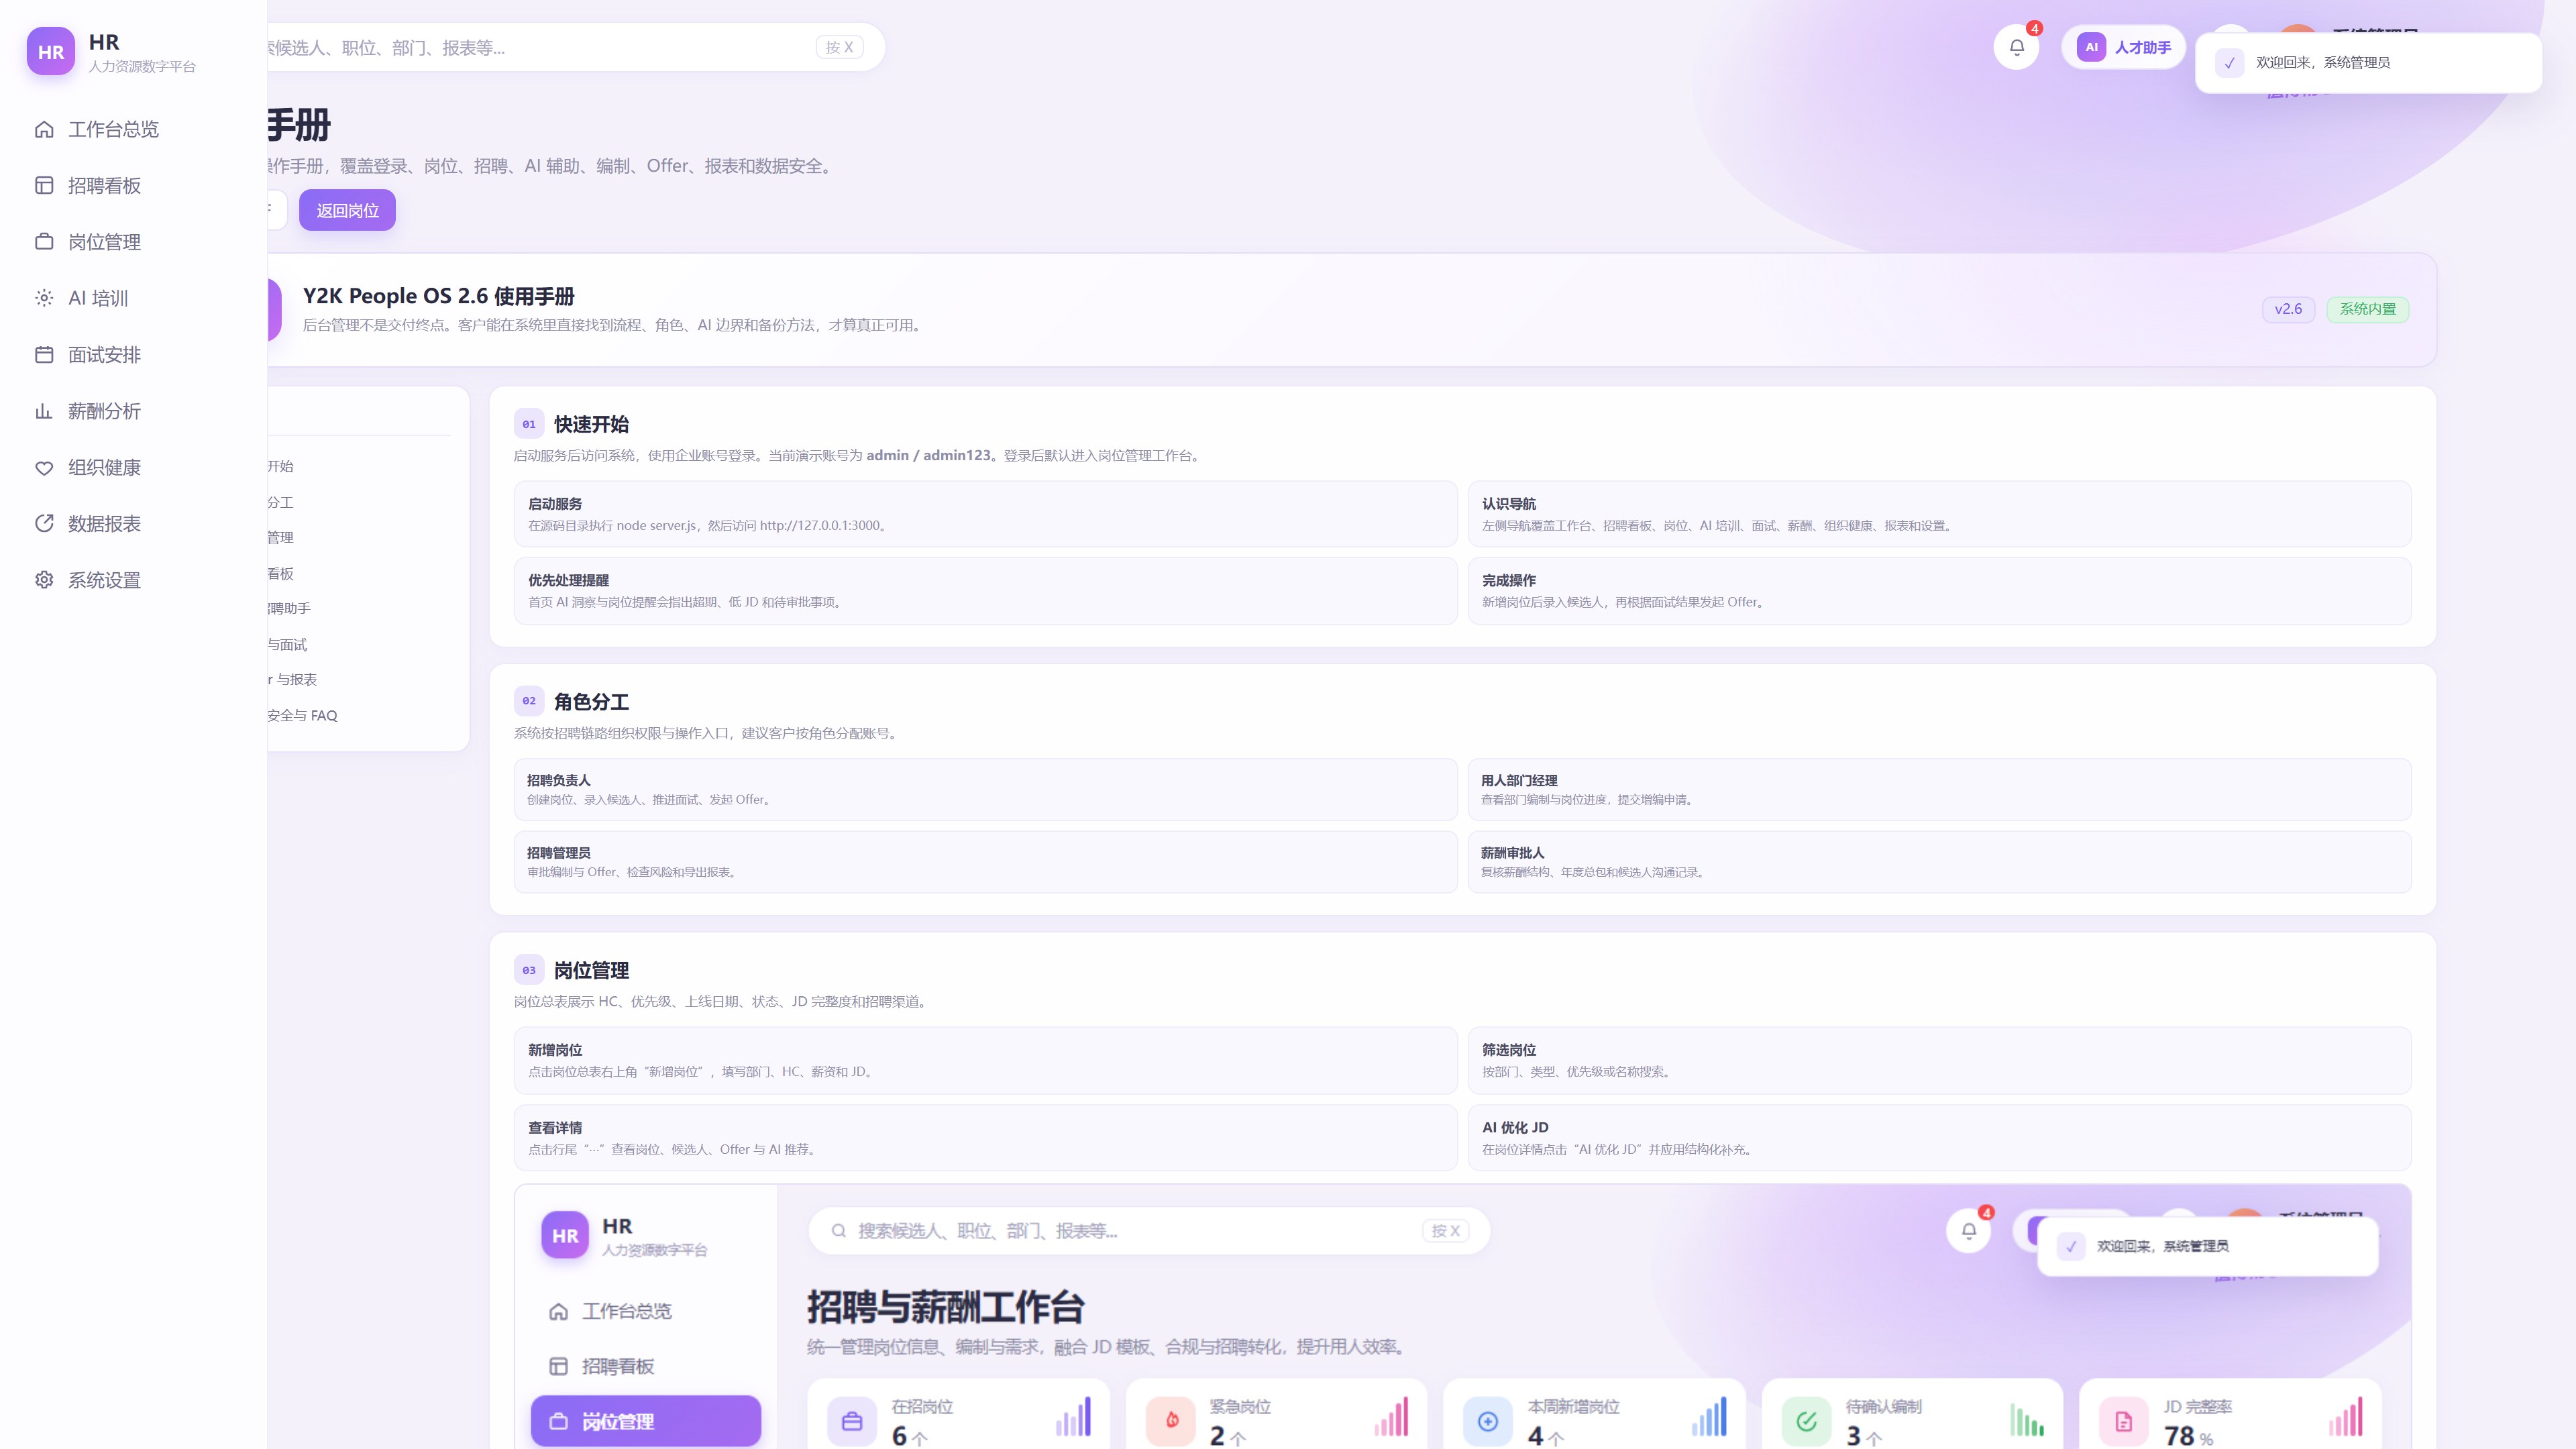
八、这次项目最大的教训
- 客户提供的原稿就是约束,不是灵感参考。
- 通用视觉规范不能覆盖客户明确指定的风格。
- 功能增强不能以重排页面为代价。
- AI 应嵌入业务决策点,而不是到处加聊天框。
- 招聘、编制、Offer 必须是同一条数据链。
- 金额必须用整数分,不能直接浮点比较。
- 交付手册必须能在系统内直接打开。
- 每次改动后都要做浏览器回归,不看截图不算验收。
这套系统最终保留原稿、补回功能、加入 AI,也把使用手册放回系统内部。对定制开发来说,最重要的不是“我做了多少”,而是“客户原来想要的东西,还在不在”。